El reentrenamiento de modelos de IA en producción en Colombia es el proceso de actualizar con datos recientes un modelo que ya está operando. Su objetivo es que las predicciones sigan reflejando la realidad del negocio.
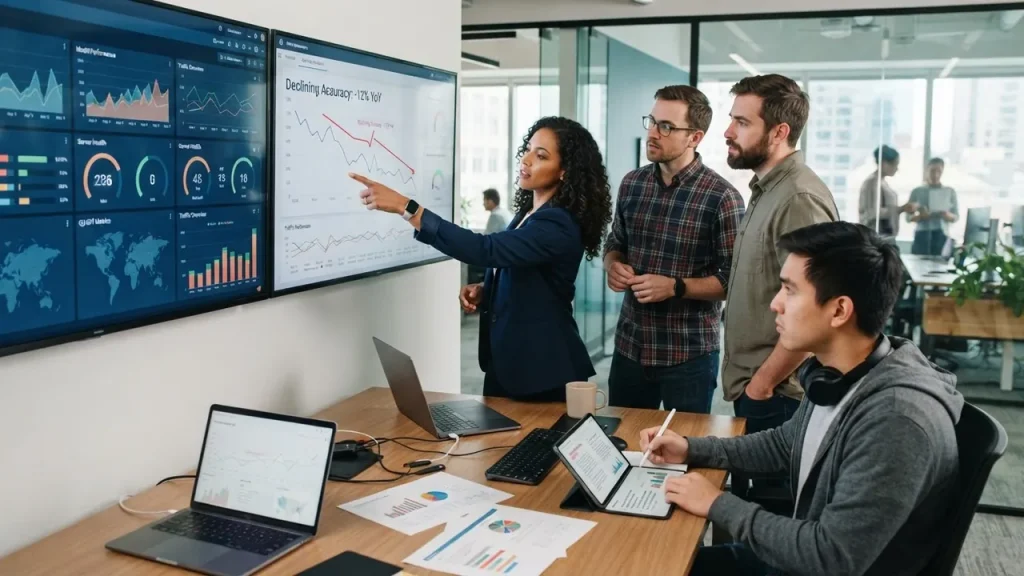
El problema aparece cuando el equipo confía en métricas que dejaron de representar la realidad: el modelo responde, pero responde mal. Los cambios de comportamiento del consumidor, la estacionalidad comercial y las nuevas reglas del negocio aceleran ese desgaste.
Esta guía explica qué señales indican que conviene reentrenar, qué datos para reentrenamiento de modelos de IA revisar antes de usarlos y cómo validar los resultados. También aclara cuándo reentrenar un modelo de IA en Colombia y cuándo lo correcto es no mover nada.
¿Qué es el reentrenamiento de modelos de IA en producción y por qué importa?
Reentrenar un modelo es volver a ajustar sus parámetros con datos más recientes para recuperar el desempeño que tenía al inicio. En producción, ese desempeño cae por dos motivos concretos: el data drift, que es el cambio en la distribución de las variables de entrada, y el concept drift, que es el cambio en la relación entre esas variables y el resultado que se quiere predecir.
Ninguno de los dos avisa. El modelo sigue entregando respuestas con la misma seguridad, aunque su criterio ya corresponda a un contexto viejo. Por eso el monitoreo importa tanto como el entrenamiento inicial.
El impacto se mide en decisiones: aprobaciones de crédito, priorización de clientes, cálculo de inventario o clasificación de solicitudes. Un modelo desalineado no falla de golpe, degrada el resultado poco a poco.
¿Cuándo conviene el reentrenamiento de modelos de IA en producción en Colombia?
Conviene reentrenar cuando la caída de desempeño es sostenida, no cuando un solo día sale mal. En Colombia, tres disparadores aparecen con frecuencia: cambios en el comportamiento de compra, modificaciones en precios o portafolio, y ajustes normativos que alteran las variables del negocio.
Antes de decidir, compara la señal observada con la acción que corresponde.
| Señal que observas | Qué significa | Acción recomendada |
|---|---|---|
| La precisión baja de forma sostenida durante varias semanas | El modelo ya no representa la distribución actual | Reentrenar con datos del periodo reciente |
| Las variables de entrada cambian de rango o aparecen categorías nuevas | Data drift | Revisar la ingeniería de variables antes de reentrenar |
| El error se mantiene alto aunque la entrada se ve igual | Concept drift | Reentrenar y revisar la etiqueta objetivo |
| Un evento puntual distorsiona los resultados | Anomalía temporal | Monitorear y esperar, sin reentrenar |
| El negocio cambió una regla clave | La lógica del modelo quedó desalineada | Reentrenar y validar con el área dueña del proceso |
La cadencia depende del ritmo al que cambia el fenómeno que el modelo predice. Un modelo de demanda se desactualiza más rápido que un modelo de clasificación documental. Reentrenar cada mes sin una razón medida consume cómputo y horas de equipo sin mejorar nada.
Datos para reentrenamiento de modelos de IA: qué revisar antes de usarlos
Los datos para reentrenamiento de modelos de IA deben venir de producción, estar etiquetados con el mismo criterio del entrenamiento original y cubrir el periodo en el que el modelo falló. Si falta cualquiera de esas tres condiciones, la nueva versión repite el problema.
La ventana temporal es la primera decisión. Un periodo demasiado corto aprende el ruido de la última semana; uno demasiado largo diluye el cambio que se quiere corregir.
Después revisa el etiquetado. Si el equipo cambió la definición de lo que considera un caso positivo, el modelo aprende una regla distinta y las métricas dejan de ser comparables.
También conviene auditar duplicados, valores faltantes y sesgo de selección, que ocurre cuando solo llegan al registro los casos fáciles. Los datos sintéticos ayudan a cubrir escenarios raros, aunque nunca reemplazan una muestra real etiquetada.
Sobre privacidad, el tratamiento de datos personales en Colombia se rige por la Ley 1581, la norma que regula su recolección y uso. Un reentrenamiento serio deja trazabilidad del origen de cada dato.
¿Cómo validar los resultados antes de publicar la nueva versión?
La validación se hace con dos conjuntos: datos que el modelo nunca vio y métricas de negocio. Un modelo puede mejorar en exactitud y empeorar el indicador que la empresa mide, así que ambas lecturas van juntas.
El esquema champion/challenger funciona bien: la versión actual sigue atendiendo el tráfico mientras la nueva responde en paralelo sobre una porción acotada. Así comparas con el mismo contexto.
Antes de publicar, define el umbral de mejora con el área dueña del proceso y prepara un plan de reversión. Si el modelo nuevo falla, el retorno a la versión anterior debe tomar minutos, no días.
Las primeras semanas después del despliegue son parte de la validación. Ahí se confirma si la mejora se sostiene o si fue un efecto del conjunto de prueba.
Cómo acompaña AMD el mantenimiento de modelos de IA
AMD Agencia Digital diseña, despliega y mantiene modelos de IA para empresas en Colombia y la región. Su enfoque de mantenimiento combina monitoreo de deriva, revisiones periódicas de datos y validación conjunta con el equipo del cliente.
Si tu modelo ya está en producción y no sabes en qué punto está, solicita una revisión técnica con el equipo de AMD.
Preguntas frecuentes sobre reentrenamiento de modelos de IA en Colombia
¿Cada cuánto conviene reentrenar un modelo que ya está en producción?
No existe una frecuencia única. La cadencia se define con el monitoreo: si la precisión se mantiene estable y las variables de entrada no cambian, un modelo puede operar meses sin ajustes. Si el negocio cambia precios, portafolio o reglas cada semana, la revisión debe ser más seguida.
¿Qué pasa si nunca reentrenas un modelo de IA en producción?
El modelo sigue respondiendo, pero con criterios que ya no corresponden al presente. El efecto aparece como errores difíciles de rastrear: recomendaciones fuera de lugar, inventario mal calculado o prioridades equivocadas en atención al cliente. Cuando el problema se hace visible, ya lleva meses avanzando.
¿Se puede reentrenar un modelo sin datos etiquetados?
Sí, con etiquetado asistido o técnicas semiautomáticas, aunque la calidad baja. Lo recomendable es etiquetar una muestra representativa del periodo reciente y comparar su desempeño contra el modelo actual. Sin una referencia etiquetada no hay forma de comprobar si la nueva versión mejoró.
¿Cuánto tarda un reentrenamiento de modelos de IA en producción en Colombia?
Depende del tamaño del modelo y del volumen de datos. Un ajuste sobre un modelo tabular toma horas; un modelo de lenguaje o de visión exige más cómputo y una validación más larga. El tiempo real se consume en preparar y etiquetar datos, no en ejecutar el entrenamiento.
¿Cómo sé si el problema está en el modelo o en los datos?
Revisa primero la entrada. Si las variables llegan incompletas, con formatos distintos o con valores fuera de rango, el fallo está en la tubería de datos y reentrenar no lo corrige. Si la entrada es correcta y el error persiste, corresponde reentrenar el modelo.
Reentrenamiento de modelos de IA en producción en Colombia: cómo sostener el resultado
El reentrenamiento de modelos de IA en producción en Colombia es una práctica de mantenimiento, no un proyecto de una sola vez. El modelo que funciona bien es el que se revisa, se valida y se ajusta cuando el contexto cambia.
Monitorear la deriva, cuidar la calidad de los datos y acordar los umbrales de mejora con el área de negocio evita que un modelo degradado tome decisiones durante meses sin que nadie lo note.
Si quieres ordenar ese proceso, agenda una revisión de tu modelo y define con AMD qué señales vas a vigilar.
