La deriva de datos y deriva de concepto en modelos de IA en producción son los dos desajustes que explican por qué un sistema que ayer acertaba empieza a fallar sin que nadie haya modificado su código.
La deriva de datos aparece cuando el entorno cambia y las entradas que recibe el modelo se alejan de las del entrenamiento. La deriva de concepto surge cuando cambia la relación entre esas entradas y el resultado que se quiere predecir.
Ambas son silenciosas. No tumban el servicio, solo degradan la calidad de cada decisión, y ese deterioro se nota en operaciones colombianas concretas.
Un modelo de scoring entrenado con la cartera de una sola ciudad pierde precisión cuando el negocio se expande a otras regiones. Un clasificador de solicitudes de servicio empieza a equivocarse cuando cambia el catálogo de productos o el vocabulario de quienes escriben.
Detectar la deriva a tiempo evita que el equipo abandone una herramienta que todavía aporta valor.
¿Qué diferencia hay entre la deriva de datos y la deriva de concepto?
La deriva de datos es un cambio en la distribución de las variables de entrada. El modelo queda intacto, pero recibe datos que se alejan de la línea base con la que se entrenó. La deriva de concepto es un cambio en la regla que une esas variables con la etiqueta, de modo que el mismo perfil puede significar algo distinto.
Un ejemplo aclara la distancia entre las dos. En un modelo de riesgo crediticio, la deriva de datos se manifiesta cuando los montos solicitados crecen y aparecen ocupaciones que no existían al entrenar. La deriva de concepto se manifiesta cuando un patrón que antes anticipaba mora deja de anticiparla, porque cambió el contexto económico o la política de cobranza.
| Criterio | Deriva de datos | Deriva de concepto |
|---|---|---|
| Qué cambia | La distribución de las entradas | La relación entre entradas y resultado |
| Estado del modelo | Sin modificaciones | Sin modificaciones |
| Señal típica | Variables con rangos o categorías nuevas | El error real sube aunque las entradas parezcan normales |
| Ejemplo | Crecen los montos de compra | Un patrón de pago cambia de significado |
| Cómo se detecta | Comparar distribuciones contra la línea base | Medir aciertos contra etiquetas verificadas |
| Cuándo revisar | De forma continua sobre las entradas | Cada vez que llegan etiquetas confiables |
¿Cuáles son las señales que avisan de que un modelo se está degradando?
La degradación se anuncia en cuatro frentes: entradas, salidas, operación y negocio. Ninguna señal aislada confirma la deriva, pero dos coincidiendo justifican abrir una revisión formal.
- Las variables de entrada muestran rangos fuera de lo histórico o categorías que no existían al entrenar.
- Crece la proporción de valores nulos, campos vacíos o textos mucho más largos que el promedio de la línea base.
- La proporción de clases en la salida se mueve: un clasificador que repartía 70/30 empieza a repartir cerca de 50/50.
- Aumentan las reversiones de decisiones automatizadas y las correcciones manuales del equipo operativo.
- Los indicadores de negocio que dependían del modelo se desvían sin una causa comercial evidente.
¿Cómo se monitorea la deriva de concepto en IA en producción?
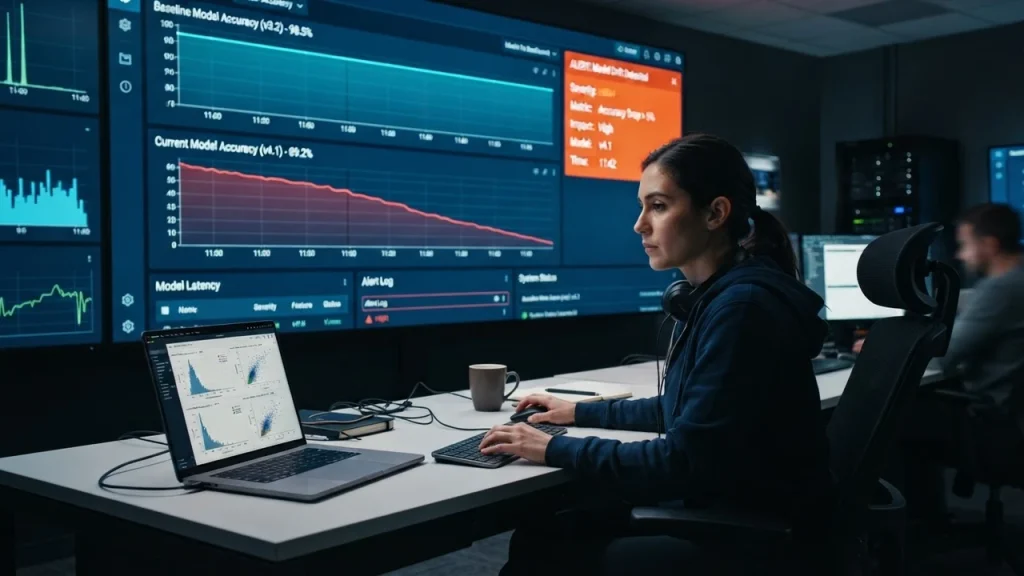
Monitorear la deriva de concepto en IA en producción exige etiquetas reales que llegan con retraso. El desenlace de un crédito se conoce semanas después de la predicción, y una venta se confirma cuando cierra el ciclo. Por eso el monitoreo trabaja en dos capas: una vigila las entradas en tiempo real y otra mide el desempeño contra resultados confirmados.
La capa de entradas compara la distribución actual con la línea base y avisa ante desviaciones. La capa de desempeño calcula precisión, recall o error absoluto sobre los casos ya resueltos. Cuando ambas se leen juntas, es posible separar un problema de datos de un problema de concepto.
La deriva de datos en modelos de IA en Colombia suele originarse en cambios normativos, ajustes de precios y nuevas formas de pago. Son factores que ningún equipo controla, pero que sí puede vigilar con alertas tempranas y con un ciclo de mantenimiento del modelo definido desde el inicio.
Un proceso de monitoreo útil sigue cuatro pasos:
- Congela una línea base con la distribución de entradas y las métricas del modelo al momento de la puesta en producción.
- Elige la ventana de comparación: diaria para volumen alto, semanal o mensual cuando el flujo es menor.
- Define umbrales junto al equipo de negocio, porque el costo de un error cambia según la decisión que dependa del modelo.
- Revisa la causa antes de reentrenar, ya que si la etiqueta cambió de significado, repetir el entrenamiento reproduce el problema.
Preguntas frecuentes sobre deriva de datos y deriva de concepto en modelos de IA en producción
¿Cómo sé si mi modelo sufre deriva de datos o deriva de concepto?
Si las entradas se ven distintas a la línea base, sospecha deriva de datos. Si las entradas se ven normales pero el error contra etiquetas reales sube, sospecha de deriva de concepto. Para confirmarlo, compara las dos capas en la misma ventana de tiempo y revisa en qué momento se separaron sus curvas.
¿Cada cuánto se debe revisar la deriva de un modelo en producción?
La revisión de entradas conviene hacerla de forma continua o diaria, según el volumen. La revisión de concepto depende de cuándo llegan las etiquetas verificadas: si el resultado tarda un mes, la medición real tarda lo mismo. Lo que no se sostiene es revisar solo cuando el negocio ya reportó pérdidas.
¿Qué necesito para medir la deriva de concepto en un modelo de IA?
Necesitas tres cosas: una línea base guardada, un flujo de etiquetas reales y una métrica de desempeño definida antes de la puesta en producción. Sin etiquetas confiables no hay forma de medir concepto, solo de vigilar entradas y de intuir qué está pasando.
¿La deriva de datos en modelos de IA en Colombia tiene causas locales?
Sí. Los cambios normativos, los ajustes de precios, la estacionalidad de las regiones y la adopción de nuevos canales de pago modifican el comportamiento de los usuarios. Esos movimientos aparecen primero en las entradas del modelo, así que ahí conviene colocar la primera alerta.
¿Reentrenar el modelo resuelve cualquier tipo de deriva?
No. El reentrenamiento corrige la deriva de datos cuando hay suficiente historia nueva y etiquetas confiables. Si el problema es de concepto, reentrenar con los mismos criterios y sin revisar la etiqueta solo traslada el error. Primero identifica el tipo de deriva, después decide la intervención.
Deriva de datos y deriva de concepto en modelos de IA en producción: cuándo pasar del aviso a la acción
La deriva no se elimina, se administra. Un modelo en producción vive en un entorno que cambia, así que la pregunta útil gira alrededor del ritmo con que se detecta y de la evidencia disponible. Los equipos que documentan la línea base, vigilan entradas y miden desempeño con etiquetas reales deciden con datos en lugar de intuición.
AMD Agencia Digital acompaña procesos de mantenimiento de modelos de IA, con revisión de datos, métricas y criterios de reentrenamiento adaptados a cada operación. Si tu modelo ya muestra señales de degradación, solicita una revisión de mantenimiento y define con criterio cuál es el siguiente paso.
