La interpretabilidad y el sesgo en modelos de IA personalizados son dos caras del mismo problema: un sistema que no puedes explicar tampoco puedes auditar. Cuando un modelo decide qué solicitud aprobar, la empresa necesita entender por qué llegó a ese resultado. También necesita saber si trata a todos los grupos por igual.
Ese control dejó de ser un lujo técnico. Actualmente, las áreas de riesgo, auditoría y cumplimiento piden evidencia de que el modelo funciona como se espera. Sin esa evidencia, la adopción se frena y el proyecto queda en piloto.
¿Qué significa interpretabilidad y sesgo en modelos de IA personalizados?
La interpretabilidad es la capacidad de explicar cómo un modelo llega a su resultado. El sesgo es la desviación sistemática que hace que ese resultado favorezca o perjudique a un grupo de personas.
Un modelo entrenado con datos históricos aprende también los patrones injustos de ese historial. Si una empresa rechazó créditos durante años en ciertas zonas, el modelo replica ese rechazo aunque nadie lo programó.
Los sesgos aparecen en tres frentes. En los datos, cuando la muestra no representa a toda la población. En las variables, cuando un dato neutro funciona como sustituto de género, estrato o etnia. Y en el etiquetado, cuando los criterios humanos que definieron el resultado ya venían cargados de sesgo.
En Colombia, la Ley 1581 de 2012 regula el tratamiento de datos personales y la Superintendencia de Industria y Comercio vigila su cumplimiento. Un modelo que decide sobre personas entra en ese terreno.
Explicabilidad de modelos de IA personalizados: técnicas que puedes aplicar
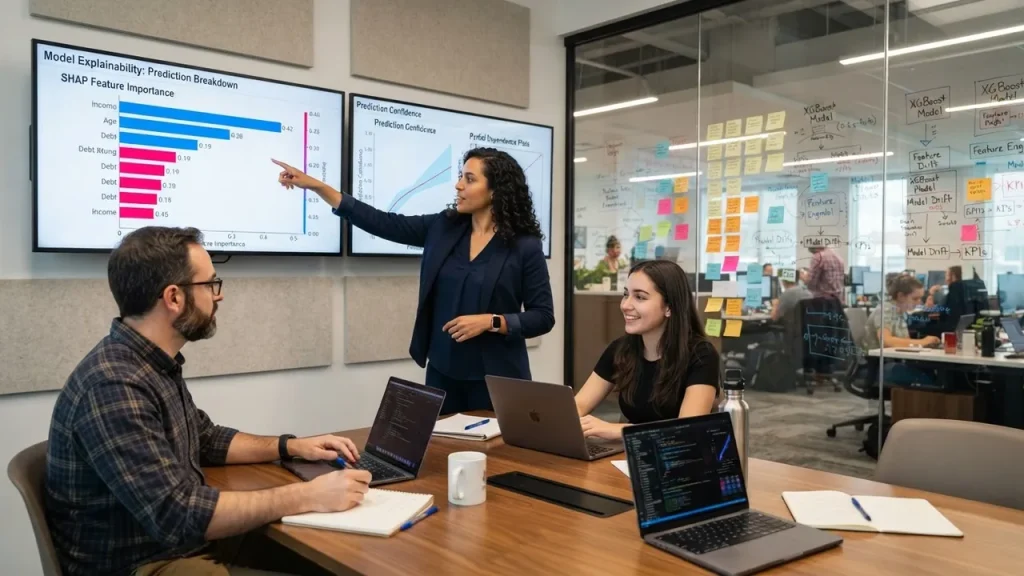
La explicabilidad de modelos de IA personalizados traduce el comportamiento del modelo a razones comprensibles. Existen técnicas consolidadas y cada una responde una pregunta distinta.
SHAP (Shapley Additive Explanations) reparte el peso de cada variable en una predicción concreta. LIME (Local Interpretable Model-agnostic Explanations) construye un modelo simple alrededor de un caso puntual para aproximar su lógica. La importancia por permutación mide cuánto cae el desempeño cuando se altera una variable.
Los modelos de árbol y las regresiones permiten lectura directa. Las redes profundas exigen capas de interpretación posteriores. Por eso la elección del algoritmo es también una decisión de gobernanza.
| Técnica | Pregunta que responde | Cuándo usarla | Límite principal |
|---|---|---|---|
| SHAP | Qué variables pesaron en esta predicción | Auditorías puntuales y modelos tabulares | Costo alto en modelos muy grandes |
| LIME | Por qué el modelo decidió así en este caso | Explicaciones para el usuario final | La aproximación varía entre ejecuciones |
| Importancia por permutación | Qué variables mueven el desempeño global | Selección de variables y diagnóstico | No explica casos individuales |
| Pruebas contrafactuales | El resultado cambia si cambio el atributo sensible | Detección de sesgos | Exige definir bien el atributo |
¿Cómo se realiza la detección de sesgos en modelos de IA?
La detección de sesgos en modelos de IA parte de definir qué grupos comparas y con qué métrica. Sin esa definición previa, cualquier resultado se vuelve interpretable a conveniencia.
El proceso tiene cuatro pasos. Primero, identificar los grupos protegidos relevantes. Segundo, medir métricas de paridad, como la tasa de aprobación por grupo o la igualdad de oportunidad. Tercero, ejecutar pruebas contrafactuales que cambian solo el atributo sensible. Cuarto, monitorear en producción, porque el sesgo aparece con datos nuevos.
Criterios de confianza y control para tu modelo en Colombia
La confianza no se declara, se documenta. Un modelo en producción necesita trazabilidad de versiones, registro de decisiones y un responsable claro de su mantenimiento.
Marcos como ISO/IEC 42001, la norma internacional para sistemas de gestión de inteligencia artificial, y el NIST AI RMF, el marco de gestión de riesgos de IA, ordenan ese trabajo. Definen qué documentar, cómo evaluar riesgos y quién responde.
AMD Agencia Digital acompaña a empresas colombianas en el diseño, el entrenamiento y la auditoría de modelos personalizados. Su enfoque combina métricas de desempeño con controles de explicabilidad y revisión de sesgos antes de cada despliegue.
Preguntas frecuentes sobre interpretabilidad y sesgo en modelos de IA personalizados
¿Qué diferencia hay entre interpretabilidad y explicabilidad en un modelo de IA?
La interpretabilidad describe qué tan comprensible es el modelo por su propia estructura. La explicabilidad es el conjunto de métodos que generan razones sobre sus decisiones. Un modelo de árbol es interpretable por diseño; una red neuronal necesita técnicas de explicabilidad para justificar cada resultado.
¿Cómo sé si mi modelo de IA personalizado tiene sesgos?
Compara las tasas de resultado entre grupos protegidos y revisa si las diferencias se mantienen al cambiar solo el atributo sensible. Si el modelo aprueba a un grupo con mucha más frecuencia que a otro con perfiles equivalentes, hay una señal que exige revisión antes de seguir operando.
¿Cada cuánto se debe auditar un modelo de IA en producción?
No existe una frecuencia única. Un modelo que decide sobre personas conviene revisarlo cada vez que cambian los datos de entrada, el volumen de casos o la normativa aplicable. Además, el monitoreo de métricas de sesgo debe ser continuo, no una revisión anual aislada.
¿La interpretabilidad reduce el rendimiento del modelo?
No necesariamente. Los modelos más simples son interpretables y rinden bien en problemas tabulares. Cuando eliges una red profunda por su precisión, las técnicas de explicabilidad posteriores añaden costo de cómputo, pero no degradan la predicción en sí.
¿Qué exige la normativa colombiana sobre decisiones automatizadas?
La Ley 1581 de 2012 obliga a informar al titular cómo se usan sus datos y a atender consultas y reclamos. La Superintendencia de Industria y Comercio puede exigir explicaciones sobre tratamientos automatizados. Documentar la lógica del modelo facilita responder ante una reclamación.
Interpretabilidad y sesgo en modelos de IA personalizados: el control que sostiene la adopción
Un modelo que no puedes explicar es un riesgo que no puedes medir. La interpretabilidad y el sesgo en modelos de IA personalizados se gestionan con técnicas concretas, métricas comparables y documentación que resista una auditoría.
Empieza por definir qué grupos comparas y qué evidencia guardarás de cada decisión. Ese orden convierte la IA en una herramienta defendible ante tu equipo legal y ante tus clientes.
Si tu operación ya usa modelos y necesitas revisar su comportamiento, solicita una asesoría con el equipo de AMD Agencia Digital.
