La ingeniería de características para modelos de IA personalizados es el proceso de transformar datos crudos en variables que el modelo puede interpretar y usar para predecir. De esa traducción depende que un proyecto de inteligencia artificial resuelva un problema de negocio o se quede en una demostración.
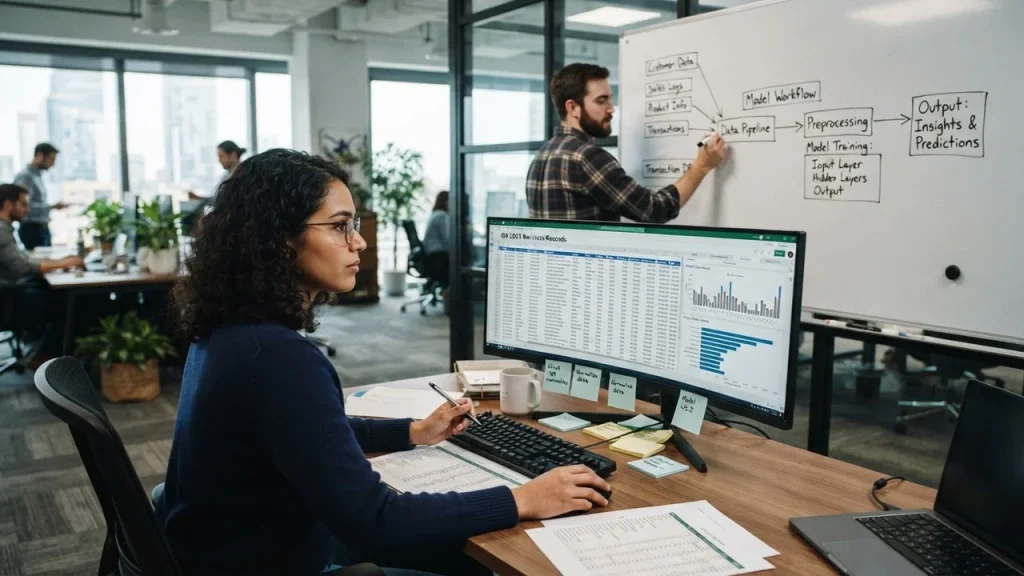
Un modelo no lee bases de datos, correos ni facturas escaneadas. Lee números ordenados en una matriz. Por eso, antes de comparar arquitecturas o proveedores, conviene revisar si tus datos ya están en condiciones de alimentar un entrenamiento.
Aquí verás qué es la ingeniería de características, cómo se conecta con el preprocesamiento de datos para IA personalizada y qué variables para modelos de IA personalizados aportan señal real en una empresa colombiana.
¿Qué es la ingeniería de características para modelos de IA personalizados?
La ingeniería de características es la etapa donde se decide qué información del negocio entra al modelo y en qué formato. Incluye crear variables nuevas, escalar valores, codificar categorías y descartar columnas que solo agregan ruido.
Un ejemplo concreto: en lugar de guardar la fecha de la última compra, se calcula «días desde la última compra». Esa variable explica el comportamiento y el modelo la puede ponderar.
Esta etapa consume más tiempo que el entrenamiento. Un equipo puede dedicar semanas a preparar variables y minutos a ajustar hiperparámetros, porque el algoritmo solo aprende de lo que recibe.
Del dato crudo a la variable: preprocesamiento de datos para IA personalizada
El preprocesamiento de datos para IA personalizada corrige la calidad antes de que los registros lleguen al modelo. Ahí se tratan valores faltantes, duplicados, formatos inconsistentes y sesgos de captura.
El orden importa. Si limpias después de entrenar, repites el trabajo y arrastras el error a producción.
- Los valores faltantes se completan con la mediana del grupo o con una marca explícita de ausencia.
- Normalizar importa: si una columna mide millones de pesos y otra mide tasas, la primera domina el cálculo.
- Para las categorías, la codificación one-hot o por frecuencia convierte texto en columnas numéricas.
- Cuando hay historial, conviene agregar rezagos y promedios móviles para que el modelo vea tendencia.
Cada decisión deja huella. Una imputación mal elegida introduce un patrón que no existe en la operación real, y el modelo lo aprende como si fuera cierto.
¿Qué variables para modelos de IA personalizados aportan señal real?
Una variable aporta señal cuando cambia el resultado del modelo y tiene sentido para el negocio. Si no puedes explicar por qué esa columna debería predecir el comportamiento, probablemente no debería entrar.
| Tipo de variable | Ejemplo en una empresa colombiana | Tratamiento habitual | Riesgo si se ignora |
|---|---|---|---|
| Numérica continua | Valor promedio de pedido | Escalado y detección de atípicos | El modelo sobrepondera montos altos |
| Categórica | Ciudad o canal de venta | Codificación one-hot o por frecuencia | Una categoría nueva rompe la predicción |
| Temporal | Días desde la última compra | Ventanas móviles y rezagos | Se pierde la estacionalidad del negocio |
| Texto libre | Comentarios de servicio al cliente | Vectorización o embeddings | Se descarta información valiosa |
La tabla resume los cuatro grupos que aparecen en casi cualquier proyecto. La selección final depende del objetivo: predecir abandono, priorizar leads o estimar demanda.
Cómo elige AMD Agencia Digital las variables de un modelo
AMD Agencia Digital es una agencia que diseña e implementa modelos de IA personalizados sobre los datos que ya tiene la empresa. Su trabajo en ingeniería de características para modelos de IA personalizados parte del problema de negocio y no de la herramienta.
El proceso empieza con una pregunta medible. Por ejemplo: qué clientes tienen mayor probabilidad de renovar. De ahí salen las variables candidatas y los criterios de evaluación.
Después se documenta cada transformación. Esa trazabilidad permite auditar el modelo, explicar una predicción y volver a entrenarlo cuando cambie la operación.
Si quieres ver cómo se estructura ese proceso de punta a punta, revisa el desarrollo de modelos de IA personalizados que ofrece la agencia.
Errores frecuentes al preparar variables para un modelo
El error más costoso es entrenar con datos que no existirían en el momento de la predicción. Se llama fuga de información y produce métricas excelentes en pruebas y resultados pobres en producción.
- Usar la fecha de cancelación como variable para predecir cancelación.
- Dejar que el conjunto de prueba comparta registros con el de entrenamiento.
- Codificar categorías con el promedio del resultado, porque filtra la respuesta.
- Ignorar el desbalance de clases, porque un modelo que nunca acierta el caso minoritario puede mostrar exactitud alta.
Preguntas frecuentes sobre ingeniería de características para modelos de IA personalizados
¿Cuánto tiempo toma la ingeniería de características en un proyecto de IA?
Depende del volumen y del estado de tus datos. Cuando las fuentes ya están integradas y documentadas, la etapa avanza rápido. Si hay que unificar sistemas dispersos y limpiar registros históricos, toma más tiempo. Conviene planear esta fase antes de prometer una fecha de salida a producción.
¿Qué diferencia hay entre ingeniería de características y selección de variables?
La ingeniería crea y transforma columnas; la selección decide cuáles se quedan. Primero se construyen candidatas a partir del conocimiento del negocio y luego se descartan las que no aportan. Hacerlo en ese orden evita perder información útil antes de probarla.
¿Necesito un data warehouse para empezar?
No es obligatorio, pero ayuda. Un repositorio central reduce la duplicación y hace reproducible cada transformación. Si tus datos viven en hojas de cálculo y sistemas separados, el primer paso es consolidarlos en una fuente confiable antes de entrenar cualquier modelo.
¿Cómo evito que el modelo aprenda sesgos de mis datos?
Revisa la representación de cada grupo en el conjunto de entrenamiento y mide el desempeño por segmento, no solo en el promedio. También documenta qué variables pueden actuar como proxy de género, estrato o región, y justifica su inclusión.
¿Qué dice la normativa colombiana sobre usar datos de clientes para entrenar modelos?
La Ley 1581 de protección de datos personales exige finalidad definida, autorización del titular y medidas de seguridad. La Superintendencia de Industria y Comercio vigila su cumplimiento. Antes de entrenar, revisa tus políticas de tratamiento y anonimiza lo que no sea necesario para el modelo.
La ingeniería de características para modelos de IA personalizados define el techo de tu proyecto
Ningún algoritmo compensa variables mal construidas. La ingeniería de características para modelos de IA personalizados marca hasta dónde puede llegar la precisión, porque el modelo aprende de la información que recibe y de nada más.
Empezar por los datos suena menos vistoso que elegir un modelo de moda. Sin embargo, es lo que separa un piloto que se apaga de un sistema que opera todos los días.
Si tu empresa ya acumula datos y quiere convertirlos en variables útiles, solicita una asesoría con AMD Agencia Digital y revisa tu caso con el equipo.
