El procesamiento de lenguaje natural para análisis de datos no estructurados es la disciplina que permite a una máquina leer, escuchar e interpretar el lenguaje humano para extraer patrones útiles. En Colombia, las empresas acumulan correos, chats, llamadas y reseñas sin un formato fijo, y esa capacidad convierte información dispersa en decisiones concretas.
Un dato estructurado vive en una tabla. Un dato no estructurado vive en un audio, un correo o un comentario. El reto no es almacenarlo, sino comprender qué dice y por qué importa.
¿Qué es el procesamiento de lenguaje natural para análisis de datos no estructurados?
El procesamiento de lenguaje natural para análisis de datos no estructurados es el conjunto de técnicas de inteligencia artificial que traducen el lenguaje humano a información medible. Cubre clasificación de textos, extracción de entidades, transcripción de voz y detección de emociones.
La diferencia con un análisis tradicional está en el punto de partida. Un modelo clásico necesita columnas ordenadas. Un modelo de lenguaje trabaja con la materia prima tal como llega: desordenada, ambigua y llena de matices.
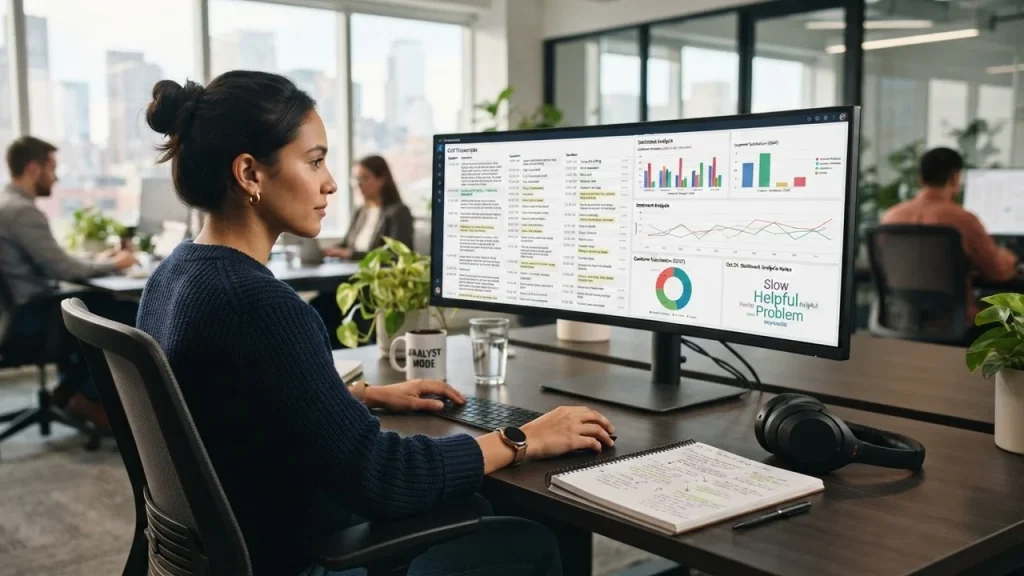
En términos prácticos, esto significa que una empresa puede analizar miles de conversaciones sin leerlas una por una. El sistema agrupa temas, marca urgencias y señala dónde se repite un problema.
¿Cómo se integran texto, voz y análisis de sentimiento en un mismo flujo?
El análisis de texto, voz y análisis de sentimiento se integra en un flujo único. Primero se transcribe el audio a texto. Luego se normaliza el lenguaje, se corrigen errores y se separan las ideas. Al final, el modelo clasifica el contenido y le asigna una carga emocional.
Cada etapa resuelve un problema distinto. La transcripción convierte sonido en palabras. La normalización limpia el ruido. La clasificación decide de qué se habla, y el análisis de sentimiento decide cómo se habla.
El resultado es una capa de datos que antes no existía. Un gerente puede ver que las quejas por demoras subieron en una regional específica, sin esperar un informe manual.
¿Qué tipos de datos no estructurados puede analizar una empresa colombiana?
Los datos no estructurados que una empresa colombiana puede analizar abarcan casi todo lo que produce su operación diaria. La clave está en identificar cuáles aportan valor y cuáles solo ocupan espacio.
| Tipo de dato | Ejemplo típico | Qué se extrae |
|---|---|---|
| Texto escrito | Correos, chats, reseñas | Temas, intención, quejas |
| Voz | Llamadas, notas de voz | Transcripción, tono, urgencia |
| Documentos | Contratos, PDF, actas | Entidades, cláusulas, fechas |
| Redes sociales | Comentarios, menciones | Sentimiento, tendencias |
| Encuestas | Respuestas abiertas | Categorías, satisfacción |
La tabla muestra que el mismo motor puede atender fuentes muy distintas. Lo que cambia es la configuración, no la base tecnológica.
¿Cuáles son los retos de aplicar NLP en Colombia?
El español de Colombia trae variaciones regionales que complican cualquier modelo. Modismos costeños, paisas o cundiboyacenses no aparecen en los corpus de entrenamiento estándar, y eso afecta la precisión.
A esto se suma la calidad del audio. Una llamada con ruido de fondo o con mala señal genera transcripciones imperfectas. El sistema debe estar preparado para trabajar con datos sucios, no con laboratorio.
También pesa la privacidad. Los datos personales exigen manejo cuidadoso y cumplimiento normativo. Un proyecto serio define desde el inicio qué se anonimiza y qué se conserva.
¿Qué gana una empresa al adoptar procesamiento de lenguaje natural para análisis de datos no estructurados?
Gana velocidad y criterio. Una decisión que antes dependía de leer cien correos ahora se apoya en un resumen automático con evidencia. El equipo deja de buscar información y empieza a usarla.
Gana también cobertura. Los modelos procesan volúmenes que ningún equipo humano alcanza a revisar. Eso permite detectar señales débiles que pasarían desapercibidas.
AMD Agencia Digital acompaña estos proyectos desde el diseño hasta la operación. La firma trabaja el análisis de datos y big data con un enfoque aplicado, orientado a que el resultado se use en la operación y no quede en un tablero decorativo.
Preguntas frecuentes sobre procesamiento de lenguaje natural para análisis de datos no estructurados
¿Qué es el procesamiento de lenguaje natural para análisis de datos no estructurados?
Es la aplicación de modelos de lenguaje para interpretar texto, voz y documentos sin formato fijo. Convierte esa información en categorías, temas y sentimientos que se pueden medir y comparar.
¿Cuánto tarda un proyecto de NLP para datos no estructurados?
Depende del alcance y la calidad de los datos. Un piloto con una fuente única puede tomar semanas, mientras que una integración con varias fuentes y sistemas requiere más tiempo y validación.
¿El análisis de sentimiento funciona con el español de Colombia?
Funciona, aunque necesita ajuste. Los modismos locales y el sarcasmo exigen entrenamiento con ejemplos reales del país para evitar lecturas equivocadas.
¿Qué necesito para empezar a analizar datos no estructurados?
Necesitas acceso a las fuentes de datos, un objetivo claro y criterios de privacidad definidos. Con eso se puede diseñar un piloto y medir resultados antes de escalar.
¿Se puede analizar voz y texto en la misma plataforma?
Sí. Un flujo bien diseñado transcribe la voz, la convierte en texto y la procesa con el mismo motor que analiza correos o reseñas. Así se comparan fuentes distintas bajo una sola lógica.
El primer paso para aprovechar tus datos no estructurados
El procesamiento de lenguaje natural para análisis de datos no estructurados deja de ser un tema técnico cuando se traduce en decisiones. Cada llamada, correo o reseña contiene una señal que hoy puede medirse.
Si tu operación genera más información de la que alcanzas a leer, explora la solución de análisis de datos y big data y evalúa por dónde empezar.
